
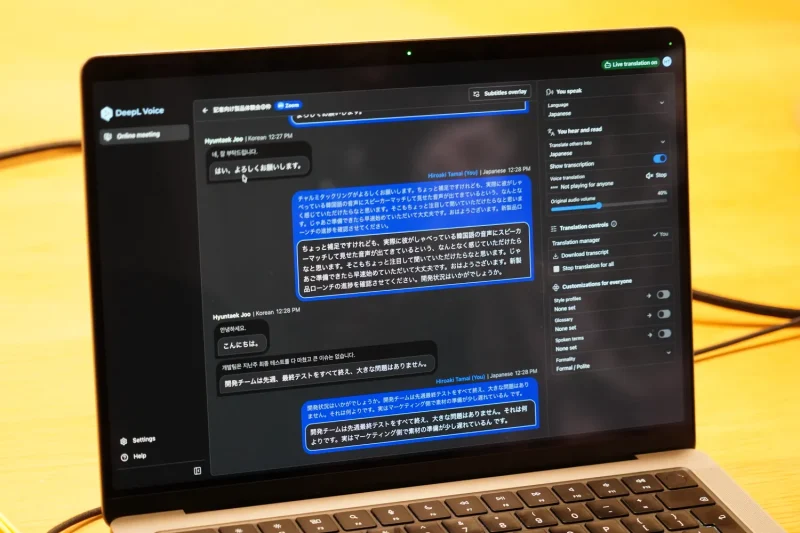
DeepLは9月15日、リアルタイム音声翻訳ソリューション「DeepL Voice」の大型アップデートを発表した。話者本人の声質や話し方の特徴を保ったまま別の言語へ翻訳する「スピーカーマッチ」に対応したほか、Zoom、Microsoft Teams、Google Meetで利用できるWindows/Mac向けデスクトップアプリも提供開始した。
音声翻訳は30以上の言語に対応し、日本語を含む14言語では話者の声の特徴を維持した音声翻訳を利用できる。さらにDeepLは、現在4~6秒程度ある音声翻訳の遅延を約2秒まで短縮する、エンドツーエンドの単一モデルの開発も進めている。
上記発表にあわせて、同社は報道関係者向けに少人数制の体験会を実施。本機能を実際に体験してくることができたほか、国内導入事例などが紹介された。


音声翻訳を「声」まで含めて伝える
「DeepL Voice」はこれまで、リアルタイムの音声をテキストへ変換して翻訳する字幕機能を中心に展開してきたが、今回DeepLが新機能として力を入れたのが、翻訳した内容を音声で届ける「Voice to voice(音声から音声への翻訳)」だ。
背景には、言葉を正しく翻訳できても、実際の会話で伝わる情報まで十分に再現するのが難しいという課題がある。人が話すときには、言葉そのものに加えて、声の高さやトーン、話すテンポ、イントネーション、間の取り方などが含まれている。DeepLは今回、こうした情報を翻訳音声にも反映するVoice AIモデルを導入した。
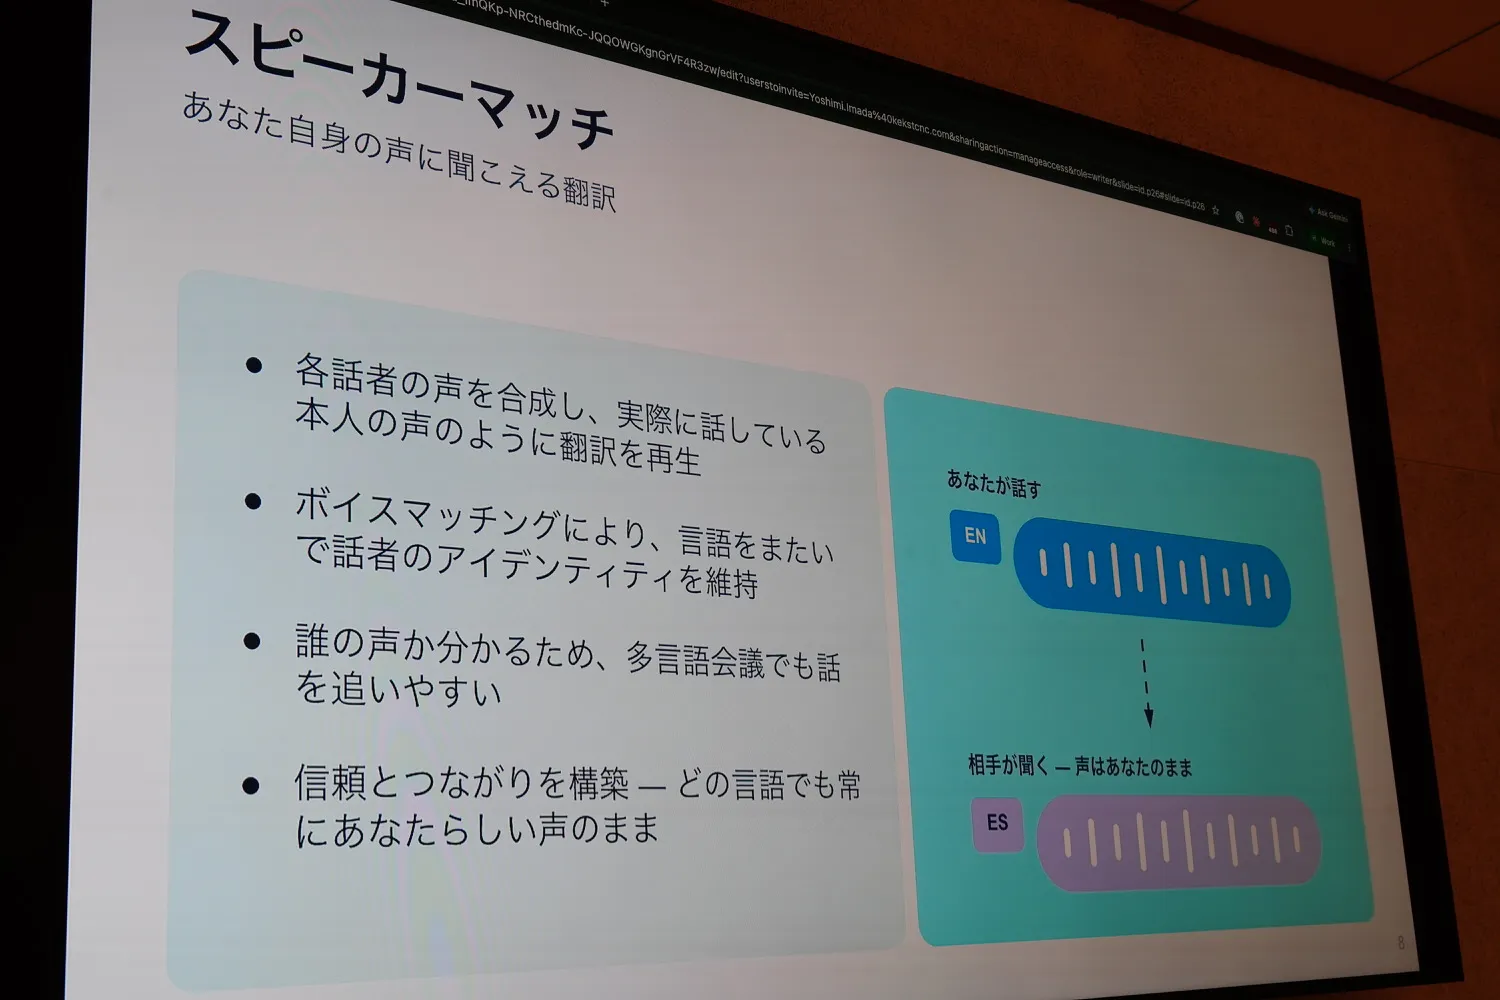
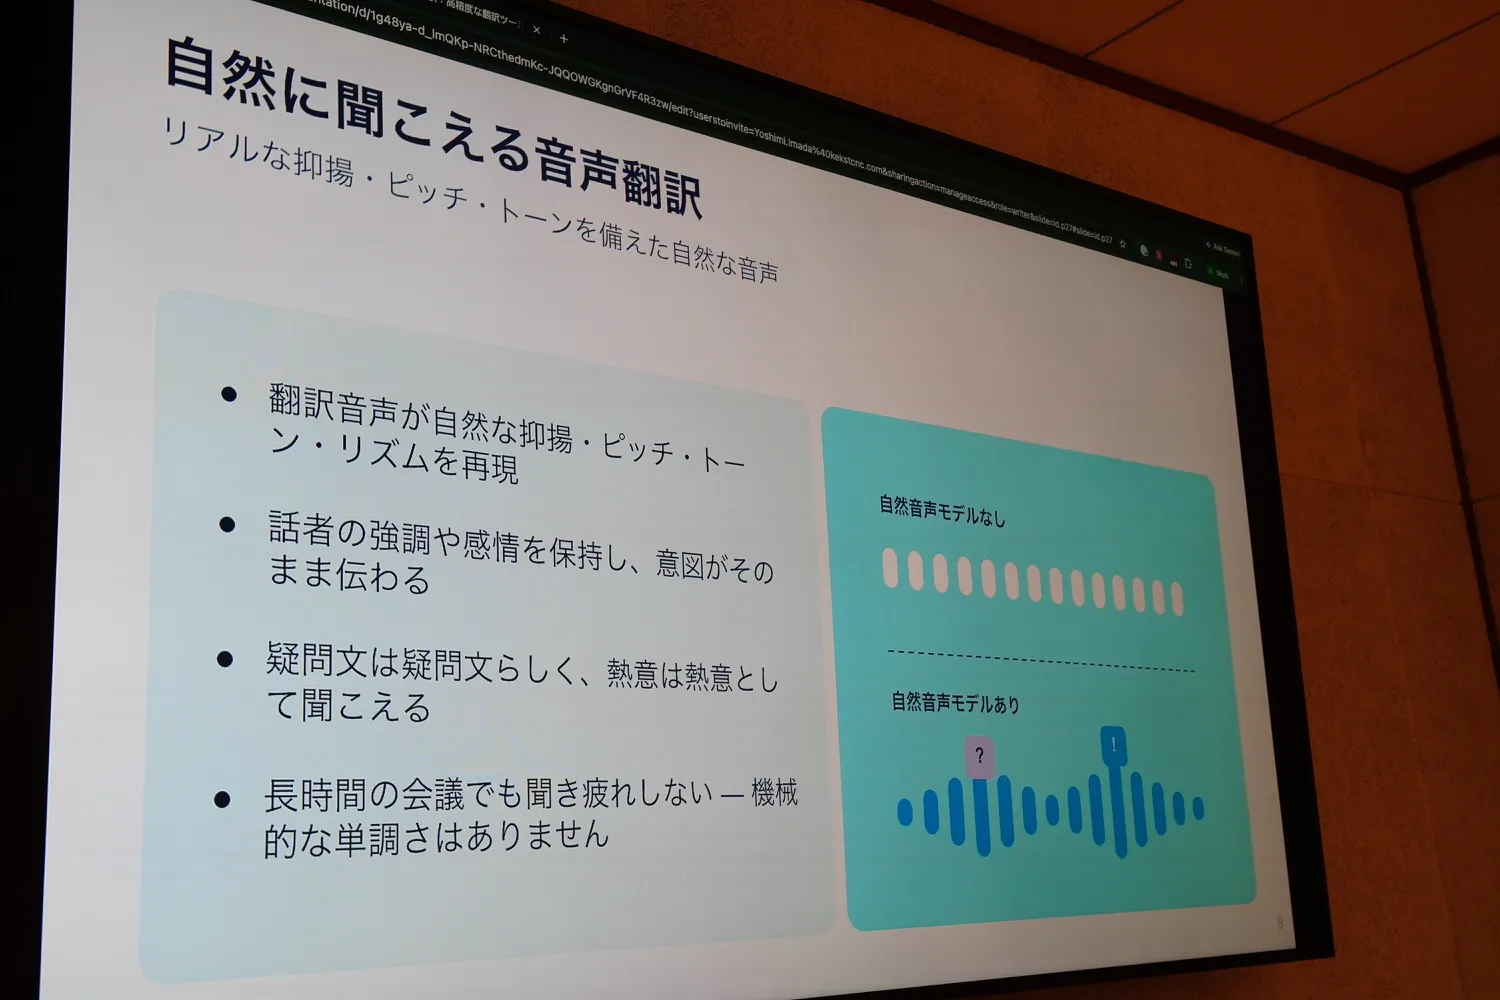
その代表的な機能が「スピーカーマッチ」だ。オンライン会議で外国語を話す相手の音声を翻訳すると、翻訳された音声にも話者の声の特徴が反映される。複数人が参加する会議でも、それぞれの話者の声の特徴を維持するため、誰が話しているのかを声から把握しやすい。
疑問文で語尾が上がるといったイントネーションに加えて、ためらい、緊急性、高揚感などの表現も翻訳音声に反映する。
DeepLによると、今回の開発では「話者の声の特徴」「翻訳品質」「低遅延」の3つを同時に成立させることが課題になったという。
翻訳品質については、AI翻訳業界の専門メディアSlatorが実施した独立評価で、DeepL Voice for Zoomが96.4点、DeepL Voice for Teamsが96.3点の品質スコアを記録した。Microsoft Teams、Google Meet、Zoomの標準機能と比較した評価で、英語と日本語、韓国語、フランス語、ドイツ語、イタリア語、スペイン語、ポルトガル語など14の言語組み合わせを対象としている。
スピーカーマッチは、事前に自分の声を録音して登録する必要がない点も特徴だ。
DeepLは会議中の音声からローリングサンプルを取得し、音声合成の参照データとして一時的にメモリ上で利用する。録音や音声データのアップロードは行わず、会議終了後にはサンプルを破棄する。会議をまたいで音声を再利用したり、音声プロファイルを作成したりすることもない。また、利用者の声や会議音声、文字起こし、翻訳結果をモデルの訓練や微調整に使わないとしている。
企業向けの利用を考えると、こうした設計は重要だ。従業員の声をあらかじめ登録しておく方式では、音声データの管理が必要になる。DeepLは、会議中だけ一時的に音声を利用することで、導入時のリスクを抑えている。
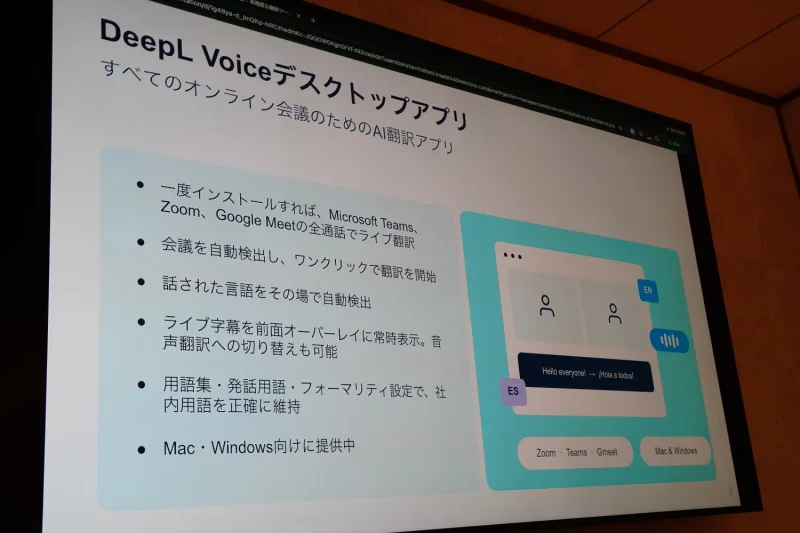
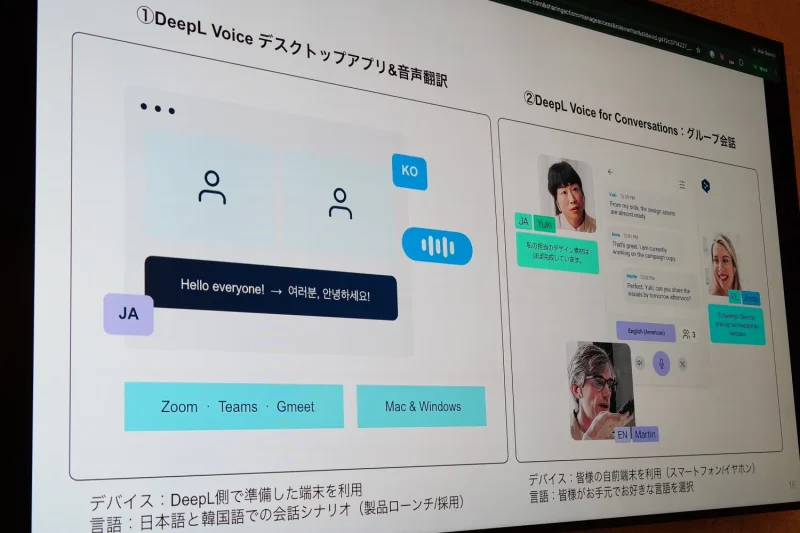
対応するオンライン会議サービスはZoom、Microsoft Teams、Google Meet。Windows/Mac向けのDeepL Voiceデスクトップアプリでは、会議を自動検出し、翻訳字幕をオーバーレイ表示できる。字幕のサイズや背景音量、翻訳設定なども変更可能で、字幕から音声対音声の翻訳へ切り替えることもできる。
4~6秒の遅延を約2秒へ、3つのAIモデルを1つに統合
現在のDeepL Voiceでは、音声認識(ASR)、機械翻訳(MT)、音声合成(TTS)の3つの処理を順番に実行している。
まず話された音声をASRでテキストに変換し、そのテキストをMTで翻訳。最後にTTSで翻訳結果を音声に変換して再生する仕組みだ。
この方式では、音声をいったんテキストに変換し、翻訳したうえで再び音声に戻す必要がある。そのため、各処理が完了するのを待って次の処理へデータを渡す必要があり、現在は4~6秒程度の遅延が発生しているという。
そこでDeepLが開発しているのが、ASR、MT、TTSの3つを1つにまとめた「エンドツーエンド」の単一モデルだ。
単一モデルでは、入力された音声を1つのモデル内でまとめて処理し、翻訳した音声を直接出力する。3つの処理を分けずに扱うことで、会話の内容や文脈に応じて、どのタイミングで翻訳音声を出力するかを柔軟に判断できるようになる。
例えば、文脈を待つ必要がない挨拶や短いフレーズであれば、話し終わるのを待たずに翻訳音声を再生する。一方、語順や文法構造が異なり、文末まで聞かなければ正確に翻訳できない文章では、必要な分だけ文脈を待ってから出力する。
つまり、すべての発話を一律に待ってから翻訳するのではなく、発話の内容に応じて「すぐに訳す」「少し待ってから訳す」をモデル自身が判断することで、翻訳の正確さを保ちながら遅延を抑えることを目指している。
DeepLは、この仕組みによって遅延を約2秒まで短縮することを目指している。すでにプロトタイプがあり、精度や挙動の調整を進めているという。
単一モデル化によって、音声に含まれる情報の扱い方も変わる。現在のスピーカーマッチでも声の高さやトーン、イントネーション、高揚感などを翻訳音声に反映しているが、音声入力から翻訳音声の出力までを一体として処理することで、こうした情報をより直接的に扱えるようになる。
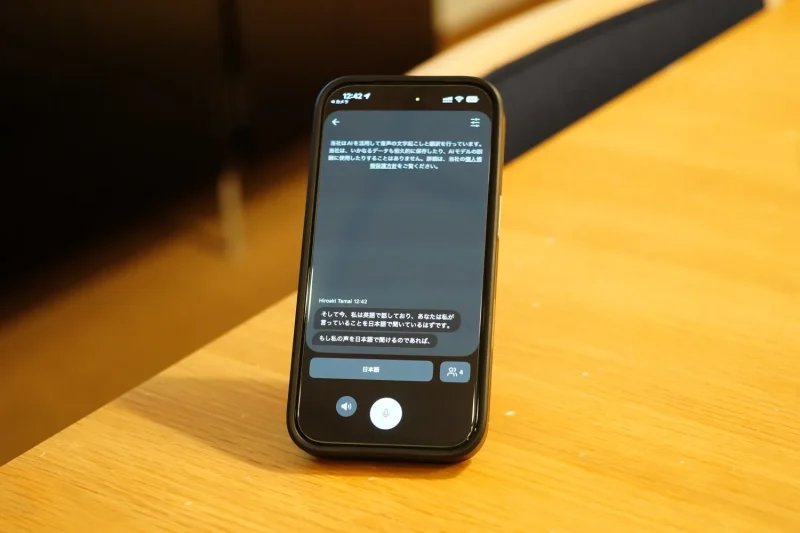
音声翻訳はオンライン会議だけでなく、対面でのコミュニケーションにも活用できる。スマートフォン向けの「グループ会話(DeepL Voice for Conversations)」では、ホストがバーチャルルームを作成してQRコードを表示し、参加者がそれぞれのスマートフォンでQRコードを読み取ることで、複数人・複数言語によるリアルタイムの会話を始められる。
参加者は自分のスマートフォンで受け取りたい言語を設定しておく。誰かが発言すると、その内容が設定した言語に翻訳され、各自の端末にテキストで表示されるほか、イヤホンを通じて翻訳音声も聞ける。日本語、英語、中国語、韓国語など、異なる言語を話す人が同じ場に集まる開発チームの打ち合わせや国際イベントなど、複数の言語が飛び交う場面で活用できる。
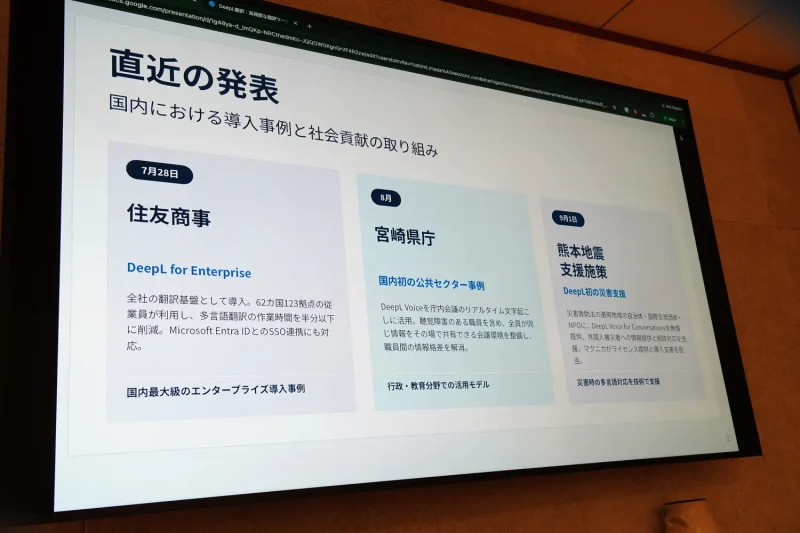
企業や行政での導入も進んでいる。住友商事では全社で「DeepL Voice」を導入。宮崎県庁では、聴覚障害のある職員が会議に参加するための支援に利用されている。
また、熊本地震の被災地域では、自治体やNPO、国際交流団体などに「グループ会話」が無償提供され、ベトナム人やインドネシア人などの外国籍住民への情報提供や相談対応にも活用された。
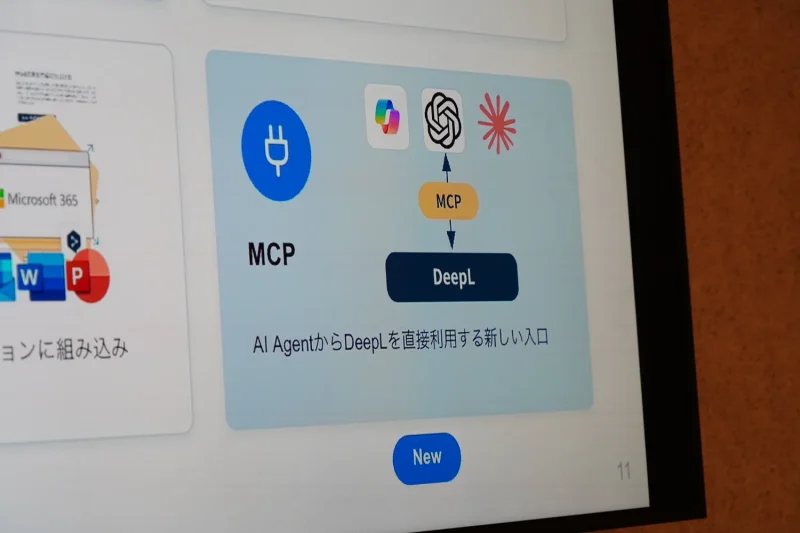
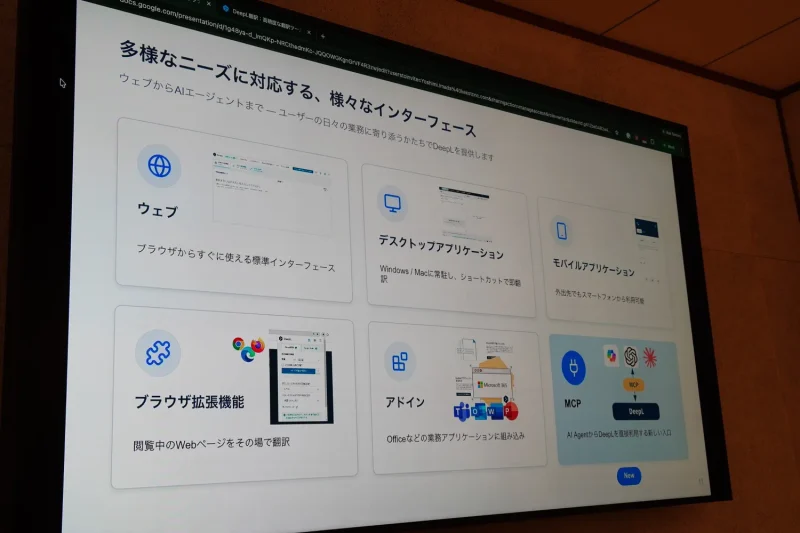
テキスト翻訳では「Remote MCP(Model Context Protocol)」にも対応する。
MCPを利用すると、ChatGPTやClaudeなどのAIエージェントからDeepLの翻訳機能を呼び出せる。AIエージェントで作成した文章を別の画面へコピー&ペーストする作業を減らし、チャット画面から直接翻訳を実行できる。
PDFなどの文書についても、レイアウトを維持した翻訳機能をAIエージェントから直接利用可能だ。
また、DeepL Voiceでは専門用語を登録して翻訳に反映させることもできる。企業や業界独自の用語、略語、製品名などを登録し、リアルタイムの会話でも適切な翻訳を行えるようにしている。
DeepL Voiceの料金は利用するプランによって異なる。現在のDeepLの有料翻訳プランでは、ユーザー1人あたり毎月30分のDeepL Voice利用枠が追加料金なしで含まれる。
対象プランにはIndividual、Team、Businessなどがあり、公式サイトではIndividualが年払いで月額換算7.49ユーロ、Teamが24.99ユーロ、Businessが49.99ユーロとなっている。Enterpriseは個別見積もりとなる。
「Voice to voice」を利用する場合は、翻訳された音声を聞く参加者にも対象となるVoiceライセンスが必要になる。「グループ会話」の場合は、ホストがライセンスを保有していれば、参加者側はライセンスの有無に関係なく、翻訳機能を利用可能だ。