NVIDIAは11月10日、東京で開催した開発者向けイベント「NVIDIA Agentic AI Day」で、日本市場向けの合成データセット「Nemotron Personas Finance Japan」と「Nemotron PII Japan」を発表した。
「Nemotron Personas Finance Japan」は、日本の金融サービスを利用する顧客の人物像を再現したデータセット。「Nemotron PII Japan」は、日本語の文書に含まれる個人情報をAIに検出させるためのデータセットだ。どちらも実在する個人の情報を使わず、AIモデルやAIエージェントの開発・評価に利用できる。
企業がAIエージェントを実際の業務に導入するには、AIモデルの性能を高めるだけでなく、日本の言語や商習慣、業界ごとの業務内容に合ったデータも必要になる。NVIDIAは今回、日本の金融業務や日本語の文書を想定したデータセットを公開し、国内企業のAI開発を支援する。
金融サービスを利用する900万件の人物像を生成
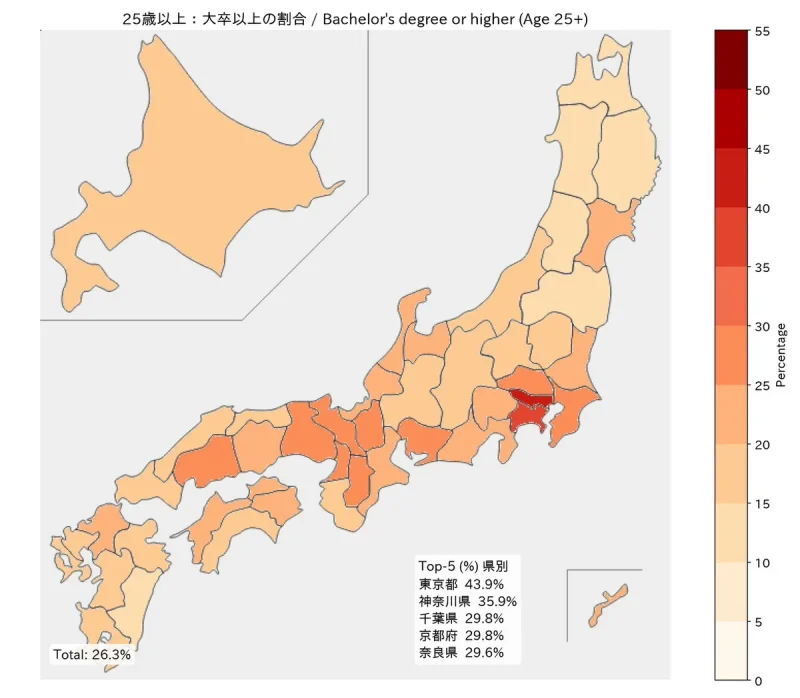
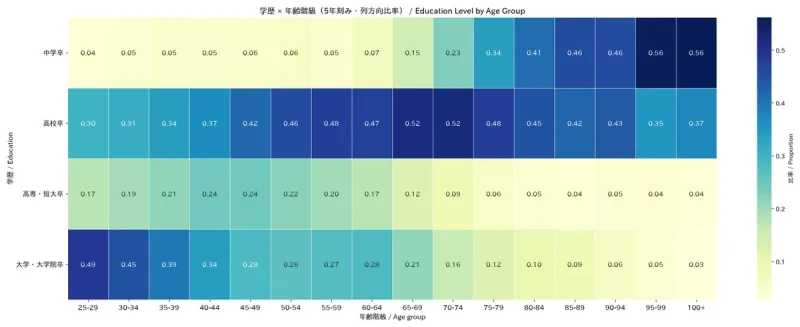
「Nemotron Personas Finance Japan」は、金融サービスの利用者を想定した架空の人物像(ペルソナ)を収録したデータセットだ。
NVIDIAが2025年に公開した「Nemotron Personas Japan」を金融分野向けに拡張したもので、年齢や職業、居住地域、趣味、スキル、キャリア志向などに加え、収入や資産、支出、貯蓄、投資、金融商品の選び方といった情報も含んでいる。
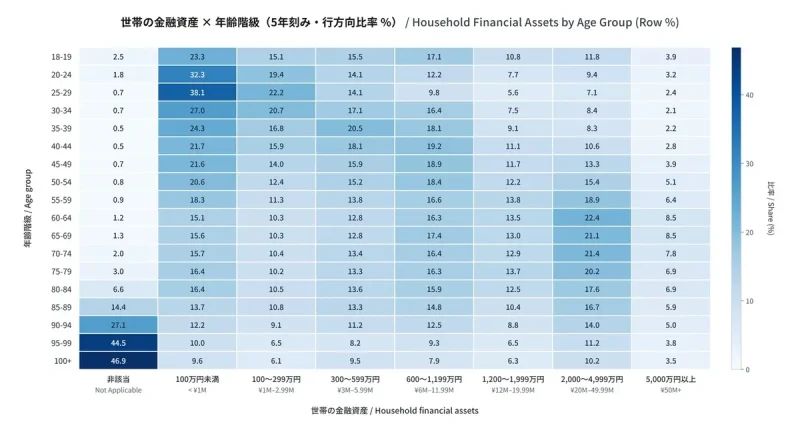
収録されている人物像は900万件。日本の人口統計や労働統計などを参考に、幅広い年齢や職業、生活背景を持つ人々を再現した。すべて人工的に生成されたもので、実在する個人の情報とは結びついていない。
たとえば、金融機関が新しい商品を企画する際に、年齢や収入、生活背景の異なる顧客がどのような反応を示すかを試す用途が考えられる。AIエージェントの顧客対応を検証したり、営業担当者の研修でさまざまな顧客との会話を再現したりすることもできる。
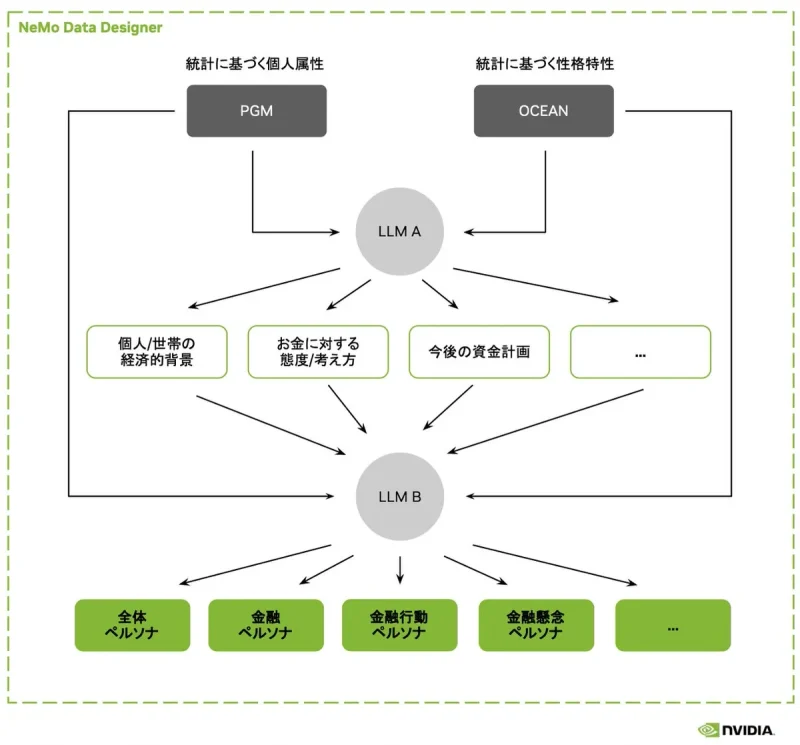
開発はNVIDIAが主導し、東京大学松尾研究所発のAIスタートアップであるElithが、データの生成パイプラインの構築や大規模なデータ生成を担当した。また、損害保険ジャパン、東京海上ホールディングス、福岡銀行、みずほフィナンシャルグループ、明治安田生命保険、金融データ活用推進協会(FDUA)も開発に協力している。
各機関は、保険や銀行業務で扱う顧客像、金融商品の提案、営業活動などについて知見を提供した。実際の顧客データや機密情報は使わず、金融業界の実務に基づく意見をデータの設計や品質改善に反映している。
「Nemotron Personas Finance Japan」は、NVIDIAの対話シミュレーション用フレームワーク「NeMo User Sim」と組み合わせて使うこともできる。AIエージェントと顧客とのやり取りを何度も繰り返し、金融商品の説明や質問への対応などを検証できる。日本の顧客像や金融サービスに合わせたテストシナリオを作ることも可能だ。
日本語の業務文書から個人情報を検出
もうひとつの「Nemotron PII Japan」は、日本語の文書に含まれる個人情報を検出するAIの開発・評価に使うデータセット。PIIは「Personally Identifiable Information」の略で、氏名や住所、メールアドレス、個人を識別できる番号などを指す。
10万件規模の文書を収録し、医療、金融、行政、雇用、教育、法律、IT・セキュリティ、Eコマースの8分野をカバーする。診断書やローン審査書類、住所変更届、各種申請書など、文書の種類は43種類に及ぶ。
各文書には架空の個人情報が記載されており、氏名や住所などがどこに書かれているのか、どの種類の個人情報に当たるのかを示す目印が付いている。このデータを使ってAIを学習させたり、検出精度を評価したりできる。
企業が生成AIに社内文書を読み込ませる場合、氏名や住所などの個人情報をあらかじめ検出し、隠す処理が必要になることがある。ただ、日本語の業務文書は書式や表現がさまざまで、個人情報の記載場所も一定ではない。こうした文書に対応するには、多様な形式のデータを使った学習や検証が欠かせない。
実際の顧客情報や社内文書を学習用データに使うと、情報漏えいにつながるおそれがある。「Nemotron PII Japan」は架空の情報で作られているため、実在する個人の情報を持ち出すことなく、日本語の文書を使った検証を進められる。
NECは今回のデータセットにアーリーアクセス参加し、日本語文書に含まれる個人情報の検出・秘匿技術を検証した。同社によると、データセットを使ってAIを追加学習させたところ、個人情報の検出率を維持しながら、関係のない部分まで個人情報と判断する誤検知を減らせたという。日本語の個人情報を検出する技術を客観的に評価できるデータは限られており、今後の製品開発や性能評価にも活用する考えだ。
日本企業のAI開発をデータから支援
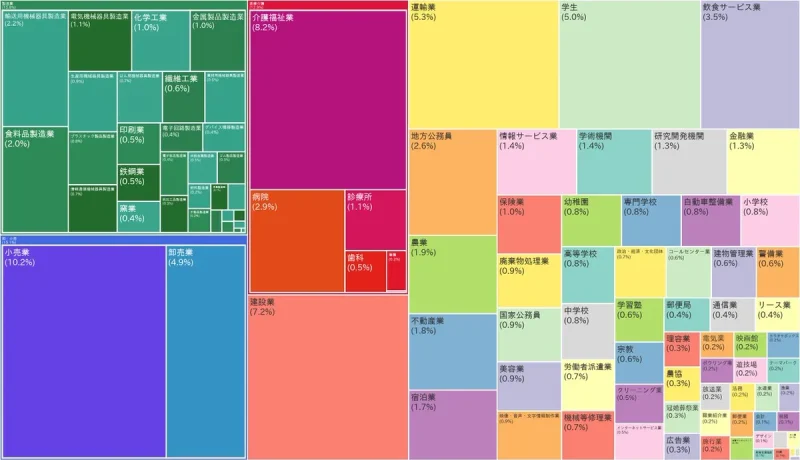
今回の2つのデータセットは、対象とする分野こそ異なるものの、日本の企業がAIを実務に取り入れる際に必要となるデータをそろえたもの。
金融向けのデータセットでは、日本の顧客像や金融業界の知見を反映したシミュレーションができる。個人情報検出用のデータセットでは、日本語の業務文書を使い、個人情報を安全に扱うための技術を検証できる。どちらも実在する個人の情報を使わずに、実際の業務に近い条件でAIを試せるようにしている。
NVIDIAは、AIエージェントを企業の業務で活用するには、AIモデルそのものの性能だけでなく、各国の言語や文化、業界ごとの事情に合ったデータが必要だと説明している。2つのデータセットは、いずれもHugging Faceで公開されており、ライセンスや利用方法などの詳細は、それぞれの公開ページで確認できる。
関連リンク
- nvidia/Nemotron-Personas-Finance-Japan · Datasets at Hugging Face
- nvidia/Nemotron-PII-Japan · Datasets at Hugging Face
(画像提供:NVIDIA)