

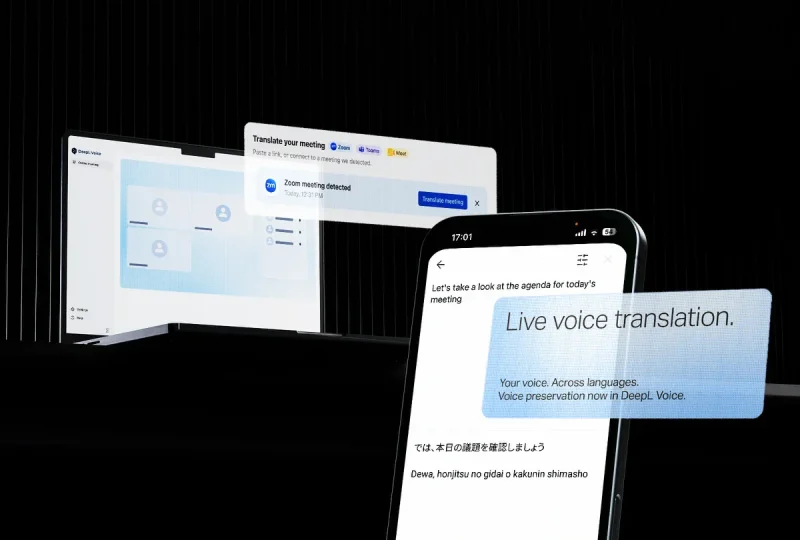
DeepLは11月11日、リアルタイム音声翻訳ソリューション「DeepL Voice」を支える新たな音声AIモデル「Aure」を発表した。
Aureは会話中の音声を継続的に分析し、話者のトーンや感情、強調の仕方、話すペースの変化を翻訳音声にリアルタイムで反映する。話者本人と認識できる声の特徴を保ちながら、会話の進行に伴う話し方の変化にも対応するという。
追加の設定は不要で、「DeepL Voice for Online Meetings」「DeepL Voice for In-Person Conversations」「DeepL API for Voice」に自動的に適用される。対応言語は英語、ドイツ語、スペイン語、フランス語、イタリア語、日本語、ポルトガル語、韓国語の8言語。今後さらに拡大する予定だ。
会話冒頭の声だけでは捉えきれない「話し方の変化」に対応
従来のDeepL Voiceは会話の冒頭で捉えた話者の声をもとに翻訳音声を生成していた。声の主が誰かを捉え、その人らしい声を再現することはできた。一方で会話の途中で変わる感情や強調、話すペースまでは追いきれなかったという。
Aureでは翻訳された言葉と元の音声の両方を用いて、入力される音声を継続的に分析する。話者が「何を話しているか」だけでなく「どのように話しているか」まで捉え、その変化をリアルタイムで翻訳音声に反映する。
実現にあたっては声の特徴や抑揚、リズムなどの話し方の特徴(プロソディ)と発話内容をそれぞれ分離する複数のトレーニング手法を組み合わせ、それぞれの要素を独立して別の言語へ反映できるようにしたという。強化学習によって出力を最適化し、翻訳の正確性と音声品質を維持しながら特定のアクセントに偏らない自然な音声を生成するとしている。
実際の会話には周囲の雑音やエコー、音声の乱れなどが含まれる。Aureはこれらを取り除きながら、話者固有の声の特徴や抑揚、リズムを捉える。異なる言語でその人らしい声を自然に再現することは、同じ言語内で再現する場合よりもはるかに複雑だという。
従来の音声翻訳は「何を言ったか」を別の言語に置き換えることが中心だった。Aureは「どう言ったか」まで翻訳の対象に広げる。交渉や発表の場では言い回しの強弱が受け取り方を左右する場面もあり、実務での意味は大きい。ただし、トーンの再現度を測る物差しは発表資料に示されていない。効果のほどは実際の利用で確かめるほかない。
声を保存しない設計。公式サイトで試聴も可能
Aureは会話中に声を動的に照合し、永続的な声のプロフィールを作ったり保存したりしない。DeepL Voiceでは会議の文字起こしや翻訳データを永続的に保存せず、セッション終了時にメモリから削除する。データは暗号化して転送し、モデルの学習には使わないという。
公式サイトではAureの試聴サンプルを用意している。安心させる口調や自信に満ちた話し方、ためらいがちな話し方など、場面ごとに原文と翻訳音声を聞き比べられる。
DeepL Voiceはパイオニア、Aramark、Avendra International、Inetumといったグローバル企業で導入が広がっているという。Fast Companyの「2026 Next Big Things in Tech」ではApplied AI部門に選出された。
DeepL創業者兼CEOのヤレック・クテロフスキー氏は「声は、その人らしさを表し、感情を伝え、人と協働し、つながるうえで欠かせないものです」と述べる。「Aureによって、会話の中で生まれるわずかな表現の変化まで捉え、その人自身の声でリアルタイムに別の言語へ反映できるようになりました。これは、話す言語が変わっても、その人らしさは変わらない世界の実現に向けた、大きな一歩です」と続けている。
関連リンク